 《HEARIM · 헤아림》 Vol.1 No.1·연구 논문·게재 2026-09-28·최초 공개: ScholarBridge 연구소 워킹페이퍼·PDF (EN)
AI 사용: 한국어판은 기계 번역(Claude/Codex) 후 영어 원문과 수식·숫자 대조 검증 · 원고 집필 단계 공개는 저자 확인 후 기재
Why this is our first paper → 표지
정확도가 아니라 꼬리 두께다: 저가 확률 모델에 판단을 위임할지 가리는 레이블 없는 선별 지표
고정된 명제에 대해 확률 하나만 돌려주는 판단 전용 모델은 이제 모든 고비용 의사결정 앞단에 둘 수 있을 만큼 저렴해졌다. 가장 자연스러운 배치 방식은 두 임계값 게이트(gate)다. 확률이 0이나 1에 가까우면 자동으로 처리하고, 그 사이의 입력은 더 강한 모델이나 사람에게 넘긴다. 본 논문은 이런 게이트가 이득이 되는지를 결정하는 양이 정확도가 아니라 꼬리 두께(tail thickness) \(\tau\), 즉 반환 확률이 0.10 이하 또는 0.90 이상인 입력의 비율이라고 주장한다. \(\tau\)는 점수 분포에만 의존하므로 레이블 없는 입력으로 측정할 수 있으며, 레이블링을 하기 전에 게이트가 줄일 수 있는 상위 처리(escalation) 비용의 몫에 상한을 준다. 이 선별 지표는 한 저가 판단 모델에 대한 선행 파일럿 측정에서 출발했다. 실제 e-메일 120건에서 모델은 양 극단에서는 정직했지만 중간 구간에서는 단조적이지 않았고, 꼬리에 들어간 입력은 5%에 불과했다. 에세이 문단 24개에서는 \(\tau\)가 기계적인 사실 질문의 83%에서 두 선호 질문의 0%까지 떨어졌고, 선호 질문에 명시적 루브릭을 써 넣어도 \(\tau\)는 0%에 머물렀다. 이어서 사전등록(pre-registration)된 다섯 개의 실험을 보고한다. 글자 수 세기 대조 실험에서는 \(\tau\) = 8.3%(균형 재검정에서 4.2%)가 나와 루브릭 결과는 교란된 것으로 판정된다. 사실형에서 선호형 순으로 배열한 일곱 개 질문을 문단 96개에 적용했을 때, 선언된 순서와 \(\tau\) 사이의 Spearman \(\rho\)는 −0.955였다. 두 선호 질문은 모두 \(\tau\) = 0%, 95% 상한 0이었다. 반복 측정 시 \(|\Delta p|\)의 중앙값은 최악의 경우에도 0.01이었다. 범용 LLM은 중요도 질문에서 \(\tau\) = 85%를 보였고 사실 질문에서는 꼬리 안 오류가 17.7%였다. 메일 데이터의 단조성 순열 검정은 \(p\) = 0.045를 주었으나 탐색적 통계량은 이와 반대 결과를 보였다. 따라서 얇은 꼬리는 캘리브레이션(calibration)된 신중함으로 읽는 것이 가장 타당하다. \(\tau\)는 게이트의 절감 폭에 상한을 주는 저렴하고 레이블 없는 초기 선별 지표이지만, 반드시 꼬리 안 오류 점검과 함께 써야 한다.
1 서론
텍스트가 아니라 판단을 파는 새로운 부류의 모델이 등장했다. 입력과 미리 지정된 명제(“이 e-메일은 원치 않는 대량 광고다”, “이 문단에는 숫자가 들어 있다”)를 주면 확률 하나를 돌려준다. 본 연구가 다루는 Jev 1.13(TypeSafe AI, 2026년 9월 출시)은 입력 토큰 백만 개당 USD 0.042이고 출력은 무료다. 첫 파일럿에서 지연 시간 중앙값은 418 ms였고, 120개 항목 벤치마크 전체 비용은 USD 0.002 미만이었다 (Insight Lab 2026년b). 이 가격이면 묻는 비용은 무시할 만하다. 공급사는 반환 확률이 캘리브레이션되어 있다고, 즉 0.9라는 답은 열 번에 아홉 번 맞아야 한다고 주장한다.
이 주장이 모든 구간에서 성립한다면 경제성 판단은 간단하다. 효율 향상이 총소비를 늘린다는 제번스의 관찰 (Jevons 1865년)처럼, 저렴한 판단은 어디에나 쓰일 것이다. 이를 구체화하는 공학적 패턴이 캐스케이드다. 저렴한 단계가 쉬운 사례를 결정하고 나머지를 고비용 단계로 넘긴다 (Viola 와/과 Jones 2001년; Chen 기타 2023년). 확률을 반환하는 모델에서 캐스케이드는 두 임계값 게이트로 환원된다. \(1-t\) 위는 자동 수용, \(t\) 아래는 자동 기각, 그 사이는 상위 처리로 넘기는 방식이며, 이는 고전적인 기각 옵션(reject option) (Chow 1970년)이자 선택적 분류 (selective classification) 설정 (Geifman 와/과 El-Yaniv 2017년)에 해당한다.
게이트를 만들 가치가 있는지는 보통 정확도나 캘리브레이션 곡선으로 판단한다. 둘 다 레이블이 필요하고, 둘 다 게이트가 전혀 쓰지 않는 구간까지 평균에 포함한다. 파일럿 데이터는 이것이 질문의 순서가 잘못된 이유를 보여 준다. 실제 e-메일 120건에서 모델의 정확도는 62%였다. 극단 구간은 정직했고(0.2 미만에서 스팸 8%, 0.8 초과에서 100%), 중간 구간은 역전되어 있었다(0.2–0.4에서 스팸 58%, 0.4–0.6에서 17%) (Insight Lab 2026년b). 이 두 사실보다 더 결정적인 것은 120개 답 중 6개(5%)만이 \(\le 0.10\) 또는 \(\ge 0.90\) 영역에 도달했다는 점이다. 이 임계값의 게이트는 오류가 없었지만 트래픽의 95%를 상위 처리로 넘겼다 (Insight Lab 2026년a).
본 논문은 과제를 이 마지막 숫자로 먼저 선별할 것을 제안한다. 기여는 다음과 같다.
- 레이블 없는 선별 지표. 꼬리 두께 \(\tau\)를 정의하고, 레이블 없는 입력만으로 두 임계값 게이트가 절감할 수 있는 상위 처리 비용 비율의 상한이 이 값임을 보인다(3절).
- 역설을 동반한 과제 수준 가설. 파일럿 측정은 \(\tau\)가 질문이 얼마나 사실형인지를 따라가며, 선호 질문에서는 0%까지 떨어진다는 것을 시사한다. 꼬리가 두꺼운 과제는 이미 규칙으로 풀리는 과제이고, 규칙으로 풀리지 않는 과제에는 꼬리가 없다 (Insight Lab 2026년a).
- 부정적 파일럿 결과. 선호 질문에 명시적 루브릭을 써 넣으면 점수 분산은 넓어졌지만 꼬리는 생기지 않았다(전후 모두 0%).
- 사전등록된 다섯 개의 실험(E1–E5, 등록된 추가 실험 E1b 포함). 이 실험들은 선별 지표의 전제를 검정한다. 모델이 계산 가능한 사실에 대해 확신을 가질 수 있는지, \(n = 96\)에서 선호성이 커질수록 \(\tau\)가 감소하는지, 단일 호출이 고정 임계값을 쓸 만큼 안정적인지, 얇은 꼬리가 이 모델에 고유한지, 메일 데이터의 비단조성이 순열 검정을 통과하는지를 본다. 실패를 포함한 모든 결과를 데이터 수집 전에 고정한 규칙에 따라 보고한다.
3 방법
3.1 꼬리 두께
판단 모델이 고정된 명제와 입력 \(x\)에 대해 \(p(x) \in [0,1]\)를 반환한다고 하자. 임계값 \(t_\ell < t_h\)에 대해 다음과 같이 정의한다.
\[ \tau(t_\ell, t_h) \;=\; \Pr_x\!\left[\, p(x) \le t_\ell \;\lor\; p(x) \ge t_h \,\right], \]
이는 표본 비율로 추정한다. 본 논문 전체에서 \(t_\ell = 0.10\), \(t_h = 0.90\)으로 두고 \(\tau\)로 표기한다. 하단 꼬리와 상단 꼬리의 운영상 의미가 다를 때(예컨대 자동 수용만 안전한 경우)는 둘을 따로 보고한다.
레이블이 필요 없는 이유. \(\tau\)는 \(p(x)\)의 주변 분포만의 범함수다. 따라서 실제 배치 입력 흐름에서 뽑은 어떤 레이블 없는 표본으로도 계산할 수 있다. 레이블은 꼬리 안의 오류를 추정할 때만 필요하고, 그 표본의 크기는 \(\tau n\)이다. 그러므로 꼬리가 얇은 과제는 거의 비용 없이 기각할 수 있고, 꼬리가 두꺼운 과제도 게이트가 실제로 처리할 항목에만 레이블을 달면 된다.
3.2 게이트의 경제성
두 임계값 게이트를 생각하자. 모든 항목에는 저가 호출 비용 \(c_J\)가 든다. 비율 \(1-\tau\)는 비용 \(c_E\)로 상위 처리되고, 자동 결정된 꼬리 항목은 비율 \(\varepsilon\)로 틀리며 건당 손실은 \(L\)이다. 모든 항목을 상위 처리하는 경우와 비교한 항목당 기대 절감액은 다음과 같다.
\[ S \;=\; \tau\,(c_E - \varepsilon L) \;-\; c_J , \qquad \frac{S}{c_E} \;\le\; \tau . \]
여기서 두 가지 결론이 나온다. 첫째, 꼬리 오류가 어떻든 절감되는 상위 처리 비용의 비율은 최대 \(\tau\)이며, 이 상한은 레이블링 전에 알 수 있다. 둘째, 호출당 가격은 \(c_J/c_E\)를 통해서만 영향을 준다. 파일럿에서 쓴 가격 비(약 225배, 판단 건당 0.002 대 0.45 US 센트; 여기서 LLM 수치는 다른 과제인 고객 문의 분류에 대해 공개된 비교치이므로 자릿수 수준의 참고치로만 쓴다 (Insight Lab 2026년b))를 적용하면 \(c_J/c_E \approx 0.004\)이다. 따라서 저가 모델의 API 비용은 제약 조건이 아니다. 실제 제약은 \(\tau\), 꼬리 안 오류 \(\varepsilon\), 그리고 이 식 밖의 고정비(통합, 상위 처리되는 \(1-\tau\) 항목에 추가되는 지연, 모니터링)다. \(\tau = 5\%\)인 과제는 기껏해야 상위 처리 비용의 5%를 줄일 수 있을 뿐이며, 이는 루프에 두 번째 시스템을 넣을 명분이 되기 어렵다.
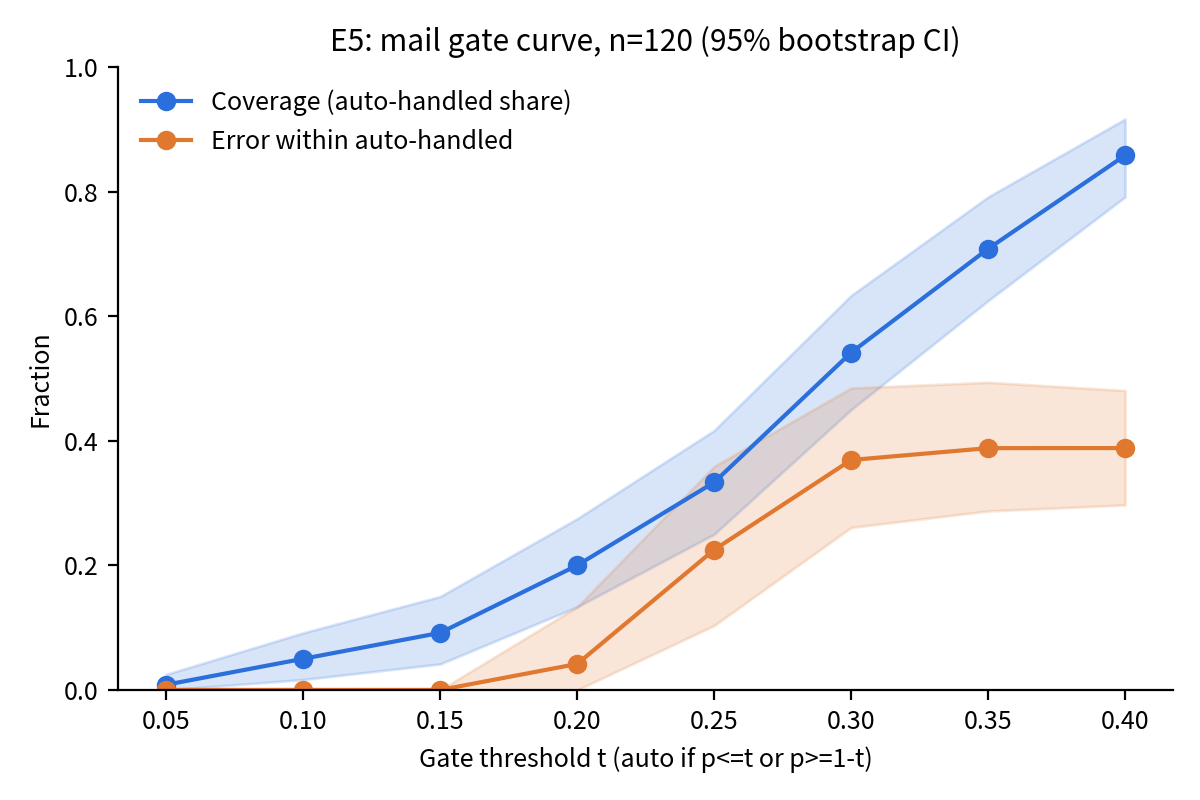
임계값을 넓히는 데도 대가가 따른다. \(\tau\)가 작으면 꼬리를 넓히고 싶은 유혹이 생긴다. 메일 파일럿에서 \(p \le t\) 또는 \(p \ge 1-t\)를 자동 결정했을 때 커버리지/오류는 \(t=0.15\)에서 9%/0%, \(t=0.20\)에서 20%/4.2%, \(t=0.25\)에서 33%/22.5%였다 (Insight Lab 2026년a). 오류가 매끄럽게가 아니라 급격하게 커지는 이유는 다음 요건 때문이다.
3.3 단조성 요건
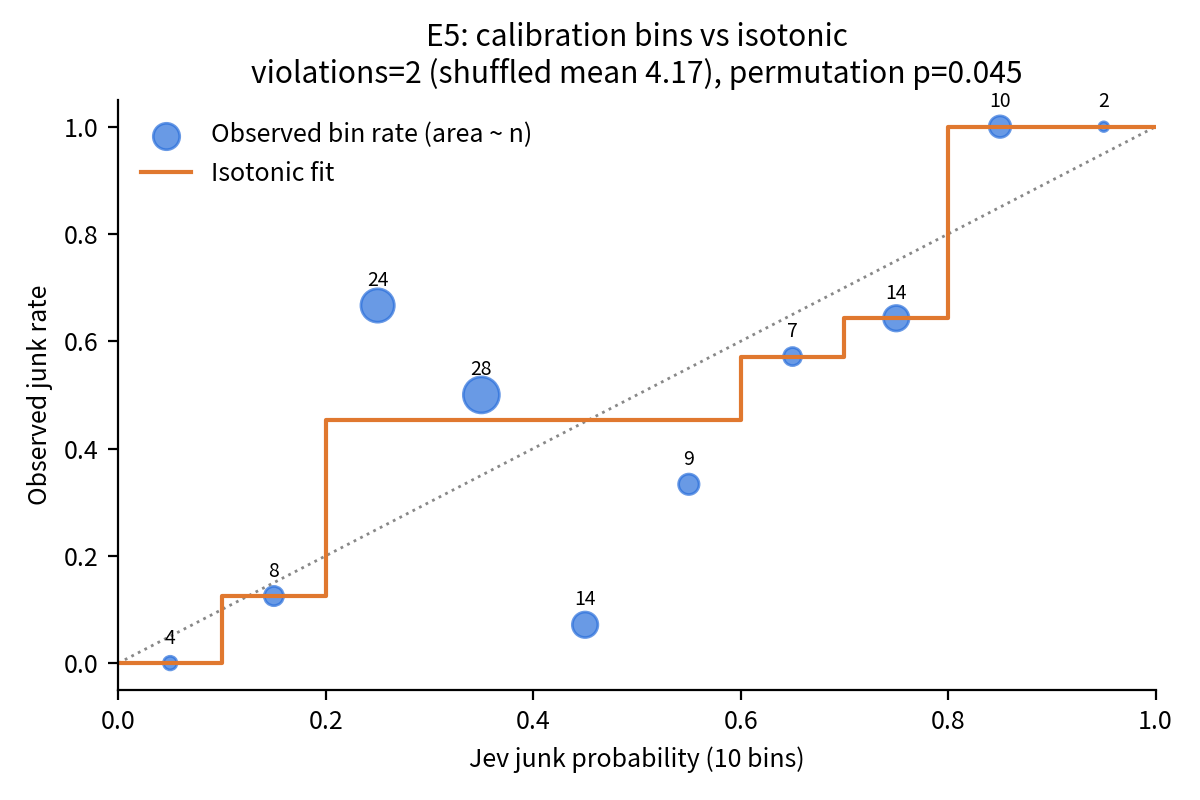
임계값 규칙은 \(\Pr[y=1 \mid p]\)가 \(p\)에 대해 비감소라고 전제한다. 그렇지 않으면 임계값을 안쪽으로 옮길 때 점수가 항목의 순서조차 제대로 매기지 못하는 영역이 들어오고, 그 영역 안에서는 어떤 \(t\)를 골라도 근거가 없다. 메일 파일럿에서 경험적 구간 비율은 \(p\)가 \([0,0.2)\), \([0.2,0.4)\), \([0.4,0.6)\), \([0.6,0.8)\), \([0.8,1]\)일 때 각각 8%, 58%, 17%, 62%, 100%였고, 구간 크기는 12, 52, 23, 21, 12였다 (Insight Lab 2026년b). 양 끝은 정직하고 중간은 역전된 형태다. 등위 재보정 (Zadrozny 와/과 Elkan 2002년)으로 단조성을 강제할 수는 있지만, 위반 구간을 합치는 방식이므로 분해능을 더하는 것이 아니라 없앤다. 따라서 본 연구는 두꺼운 꼬리를 필요조건으로, 임계값 근처의 단조성과 낮은 꼬리 오류를 추가 조건으로 보고, 후자는 \(\tau n\)개 꼬리 항목에서만 레이블로 점검한다. 실험 E5는 관측된 위반이 점수를 뒤섞었을 때 생기는 수준을 넘는지를 묻는다.
3.4 사전등록
E1–E5 프로토콜은 E1–E5 데이터가 전혀 없던 2026-09-27에 고정되었고, 해당 파일의 SHA-256 다이제스트 (74bbd759…d7d9145a)를 등록 시점에 기록했다. 프로토콜은 모델, 말뭉치, 질문 세트, 꼬리 정의, 모든 판정 임계값과 예산 상한을 고정한다. 각 가설은 등록된 규칙에 정확히 따라 지지, 비지지, 판정 불가로 보고한다. 데이터를 본 뒤에는 어떤 문구, 임계값, 표본도 바꾸지 않으며, 이탈 사항은 별도 절에 모두 적는다. 앞선 두 차례의 파일럿 탐색도 비공식적으로 같은 원칙을 따랐다. 판정 임계값(예: 루브릭 가설 지지 기준 \(\tau \ge 15\%\))을 실행 전에 탐색 스크립트에 적어 두었다.
4 실험 설정
4.1 모델과 인터페이스
모든 Jev 실험은 공급사의 System One API를 통해 OpenRouter로 접근한 Jev 1.13(TypeSafe AI)을 사용한다. 이 API는 입력 상태와 이름 붙인 명제 집합을 받아 한 번의 호출로 명제마다 확률 하나를 반환한다. 프롬프트는 제로샷이다. 그 밖의 모델 특성은 가정하지 않는다. 전체 실행에 걸친 지출 상한 USD 1.50을 중단 규칙으로 등록했다.
4.2 데이터
메일(E5 전용). 첫 파일럿의 실제 e-메일 120건(정상 60건, 스팸 60건; 레이블은 메일 서비스의 자체 폴더 분류에서 가져왔고, 모델에는 발신 도메인, 제목, 본문 첫 500자를 제공했다) (Insight Lab 2026년b). 레이블과 반환 확률만 보관하며, E5는 새로운 호출을 하지 않는다.
문단(E1–E4). 공개된 Insight Lab 저널(한국어 과학 에세이)의 문단 중 200–700자이고 표와 수식을 제외한 것을, 앞선 꼬리 탐색과 같은 규칙으로 추출했다. 실제 실행된 말뭉치에는 같은 저자의 미발표 초고도 포함되어 있었다(이탈 사항 참조). 원시 출력에는 문단 번호와 길이만 저장하며 본문은 저장하지 않는다.
4.3 선행 파일럿 측정
맥락을 제공하고 등록된 가설의 근거를 추적할 수 있도록, 이미 공개한 탐색 결과를 요약한다. 꼬리 탐색 (Insight Lab 2026년a) (\(n=24\)개 문단, 한 번의 호출에 다섯 개 명제)에서 \(\tau\)는 has_number(“이 텍스트에는 숫자나 수치가 하나 이상 들어 있다”; 꼬리 오류 0, 정규 표현식 기준 정답과의 전체 일치율 96%)에서 83%, is_method에서 33%, has_counter에서 29%였고, 두 선호 명제 is_important(범위 0.48–0.78)와 should_shorten(범위 0.22–0.36)에서는 모두 0%였다. 루브릭 탐색(같은 말뭉치 규칙, \(n=24\))에서는 각 선호 명제를 원래 문구 그대로 한 번, 저자의 명시적 규칙을 붙여 한 번, 총 두 번 물었다(중요도: 측정 결과, 핵심 주장 또는 반대 해석을 서술함; 줄이기: 400자보다 길고 동시에 중복되거나 불필요한 배경을 담고 있음). 등록된 기준(\(\tau \ge 15\%\)이면 루브릭 가설 지지)에 따라 가설은 기각되었다. 두 명제 모두 \(\tau\)는 0%에 머물렀다. 다만 is_important의 점수 범위는 0.29에서 0.62로 넓어졌다(should_shorten은 0.16에서 0.23으로). 이 결과는 모호하다. 줄이기 루브릭에는 계산 가능한 길이 조건이 들어 있으므로, 실패의 원인이 선호형 프레이밍일 수도, 길이를 아예 판단하지 못하는 것일 수도 있다. E1은 이를 가리기 위해 등록되었다.
4.4 실험
E1 — 글자 수 세기 대 프레이밍. 루브릭 탐색과 같은 24개 문단에, 명제 “이 텍스트는 400자보다 길다” (정답 계산 가능)를 묻는다. \(\tau \ge 40\%\)이고 꼬리 영역 오류가 0이면 모델이 길이를 판단할 수 있는 것이고 루브릭 결과는 선호형 프레이밍 탓으로 돌린다. \(\tau < 15\%\)이면 모델이 길이를 신뢰성 있게 판단하지 못하는 것이고 루브릭 결과는 교란된 것으로 보고한다. 그 사이 값은 판정 불가다. (루브릭 탐색 표본에서는 24개 문단 중 하나만 400자를 넘으므로, 이 대조 실험은 주로 확신 있는 부정 판단을 검정한다.)
E2 — 불확실성을 포함한 규모 확대(주 결과). 균등 표집한 \(n = 96\)개 문단에 대해 문단당 한 번의 호출로 일곱 개 명제를 묻는다. 명제는 가장 사실형에서 가장 선호형 순으로 미리 선언했다. (1) has_number, (2) has_latin_word, (3) is_method, (4) has_counter, (5) states_main_claim, (6) is_important, (7) should_shorten. 각 명제에 대해 부트스트랩 95% CI(재표집 2,000회)와 함께 \(\tau\)를 보고한다 (Efron 1979년). 가설: H2a, 선언된 순서와 \(\tau\) 사이의 Spearman \(\rho\)는 음수다. H2b, 두 선호 명제(6, 7) 모두 \(\tau\)의 CI 상한이 0.10 이하다. H2c, 정답을 무료로 얻을 수 있는 두 명제(1, 2)에서 꼬리 영역 오류율이 5% 이하다.
E3 — 반복 측정 안정성. E2의 첫 24개 문단을 동일한 입력으로 별도의 두 번째 실행에서 다시 제출한다. 명제별로 \(|\Delta p|\)의 중앙값과 90번째 백분위수를 보고한다. 어느 명제든 중앙값이 0.05를 넘으면, 그 명제에 대해서는 단일 호출이 고정 임계값 게이트에 쓰기에 잡음이 너무 크다고 판정한다.
E4 — 모델 간 특이성. 같은 96개 문단의 명제 1, 4, 6을 범용 LLM(gpt-5.6-luna, 로컬 명령줄 도구 사용)에 묻되, \([0,1]\) 범위의 확률 하나를 JSON으로 요청하는 프롬프트를 쓴다. \(\tau\)와, 명제 1에 대해서는 꼬리 영역 오류를 보고한다. 범용 LLM이 명제 6에서 \(\tau \ge 15\%\)를 보이는 반면 Jev는 약 0%이고, LLM의 명제 1 꼬리 영역 오류가 5%를 넘으면, Jev가 과소 확신한 것이 아니라 LLM이 과잉 확신한 것으로 해석한다. 그 밖의 패턴은 추가 주장 없이 기술적으로만 보고한다.
E5 — 메일 재분석(새 호출 없음). \(\tau\)와, 임계값 \(t \in [0.05, 0.40]\)에 대한 게이트 오류 곡선의 부트스트랩 95% CI를 구한다. 단조성은 관측 구간 비율을 등위 적합 (Zadrozny 와/과 Elkan 2002년)과 비교하는 방법, 그리고 단조성 위반 횟수에 대한 순열 검정(점수 5,000회 셔플)으로 \(\alpha = 0.05\)에서 평가한다.
E1b — 균형 길이 검정(등록된 추가 실험). E1 표본에는 양성 항목이 하나뿐이므로, 400자 초과 12개와 그 이하 12개로 이루어진 24개 문단 표본을 등록자가 E1 결과를 보기 전에 같은 명제와 판정 규칙으로 추가 등록했다. \(p \ge 0.5\) 기준 정확도는 두 집단에 대해 따로 보고한다.
보고. 총 지출은 약 USD 0.029였다(Jev는 144회 호출에 USD 0.0035, gpt-5.6-luna는 288회 호출에 추정 USD 0.025). 상한에 한참 못 미친다. 프로토콜 이탈 사항은 결과 절에 적는다.
5 결과
아래의 모든 숫자는 저장된 실행 출력에서 가져왔다. 백분율은 항목 비율이고, CI는 부트스트랩 백분위 구간 (재표집 2,000회, 시드 20260927)이다. 표 1 는 등록된 모든 가설과 판정을 모은 것이다.
| 실험 | 등록된 가설 / 규칙 | 핵심 결과 | 판정 |
|---|---|---|---|
| E1 | \(\tau \ge 40\%\)이고 꼬리 오류 0 → 프레이밍; \(\tau < 15\%\) → 교란 | \(\tau\) = 8.3% [0.0, 20.8] | 교란 |
| E1b | 같은 규칙, 12 + 12 균형 표본 | \(\tau\) = 4.2% [0.0, 12.5] | 교란 |
| E2 H2a | Spearman \(\rho\)(순서, \(\tau\)) < 0 | \(\rho\) = −0.955 | 지지 |
| E2 H2b | q6, q7에서 \(\tau\)의 95% 상한 ≤ 0.10 | 0.0 및 0.0 | 지지 |
| E2 H2c | q1, q2에서 꼬리 영역 오류 ≤ 5% | 3.6% (3/84) 및 0% (0/57) | 지지 |
| E3 | \(|\Delta p|\) 중앙값 > 0.05 → 잡음 과다 | 최대 중앙값 0.01 | 잡음 과다 명제 없음 |
| E4 | LLM \(\tau_6 \ge 15\%\), Jev \(\tau_6 \approx 0\), LLM q1 꼬리 오류 > 5% → LLM 과잉 확신 | 85.4%, 0%, 17.7% | 규칙 충족: LLM 과잉 확신 |
| E5 | 단조성 위반의 순열 검정, \(\alpha = 0.05\) | 위반 2회, \(p\) = 0.045 | 유의(경계선) |
5.1 E1 — 글자 수 세기 대 프레이밍
루브릭 탐색의 24개 문단 중 400자를 넘는 것은 1개뿐이다. Jev는 24개 답 중 2개를 꼬리에 두었고 (\(\tau\) = 8.3%, 95% CI [0.0, 20.8]), 둘 다 맞았다(꼬리 영역 오류 0/2). 점수 범위는 0.09에서 0.82(중앙값 0.32)였고, 평균 점수는 긴 문단 하나에서 0.50, 나머지에서 0.34였다. 0.5 기준 정확도는 83.3%로, 항상 “아니오”라고 답할 때의 95.8%보다 낮았다. \(\tau < 15\%\)이므로 등록된 판정은 교란이다. 모델은 길이 명제를 신뢰성 있게 판단하지 못하며, 루브릭 탐색의 영결과를 선호형 프레이밍 탓으로 돌릴 수 없다. 양성 집단이 \(n = 1\)이라는 점이 E1b의 동기가 되었다.
5.2 E1b — 균형 길이 검정(등록된 추가 실험)
말뭉치에는 400자 초과 문단이 21개, 400자 이하 문단이 276개 있으며, 표본은 각각에서 12개씩 뽑았다. \(\tau\)는 4.2%(95% CI [0.0, 12.5])였고 꼬리 영역 오류는 0/1, 모든 점수는 0.10과 0.64 사이에 있었다. \(p \ge 0.5\) 기준 정확도는 긴 집단에서 42%, 짧은 집단에서 92%였다. 모델은 기본적으로 “길지 않다”고 답한다. 등록된 판정은 이번에도 교란이다. E1과 E1b를 종합하면 Jev는 글자 수를 세지 않으며, 따라서 루브릭 탐색 결과로는 선호형 프레이밍과 길이 조건 평가 불능을 구분할 수 없다.
5.3 E2 — 일곱 명제에 걸친 꼬리 두께
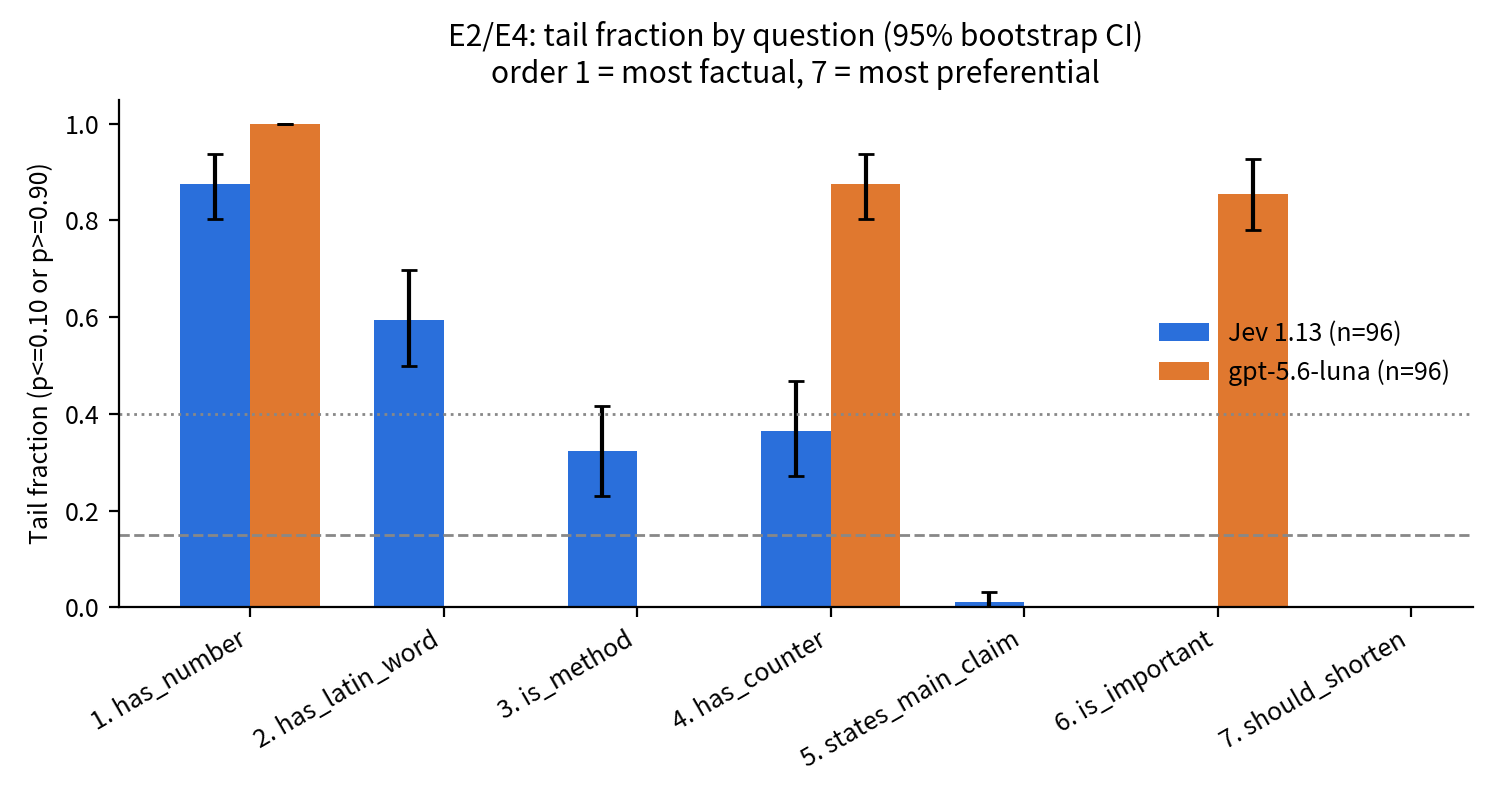
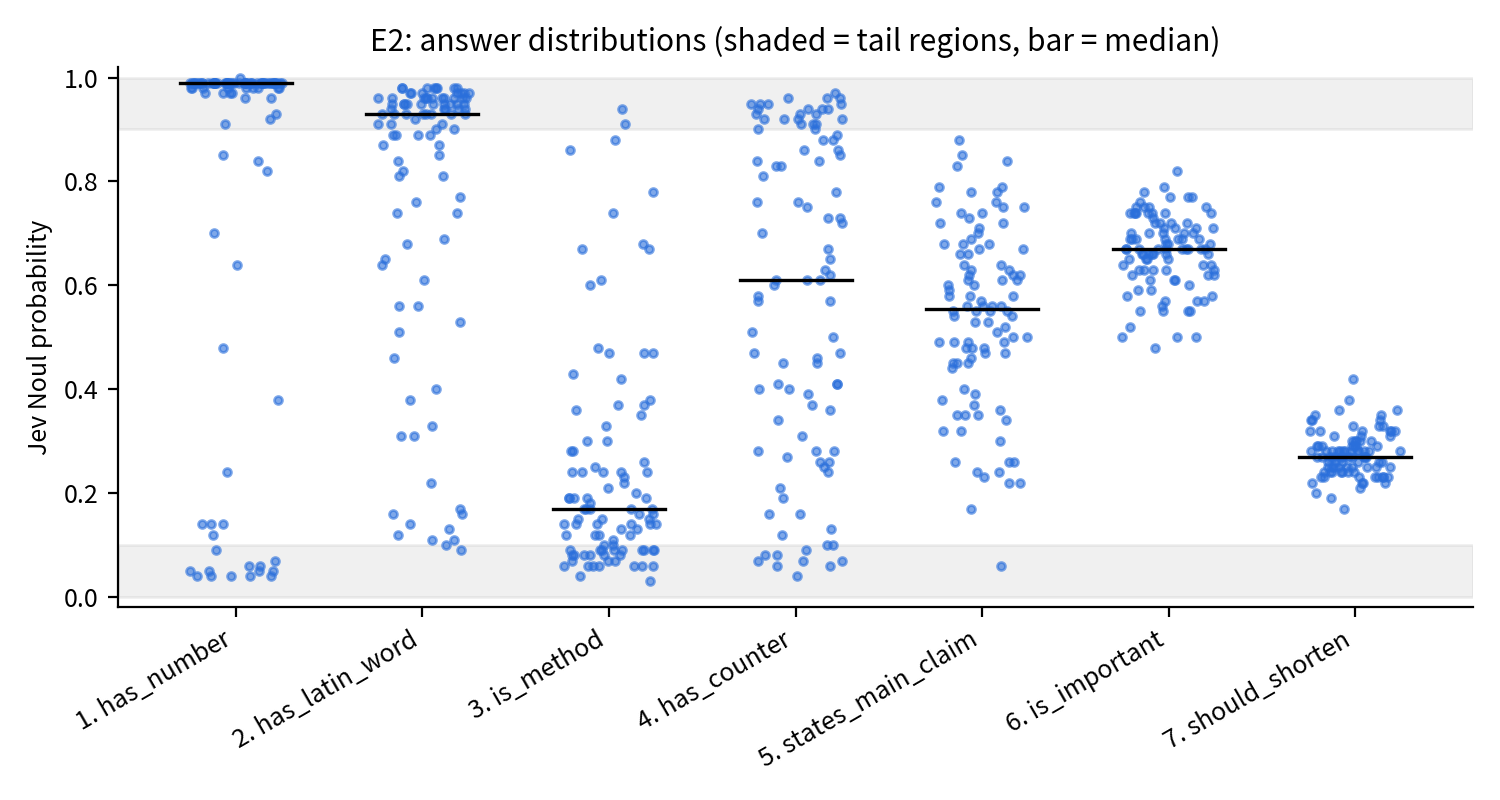
96회 호출이 모두 성공했다. 표 2 와 그림 1 는 명제별 \(\tau\)를, 그림 2 는 점수 분포를 보여 준다.
| # | 명제 | \(\tau\) | 95% CI | \(p \le .10\) | \(p \ge .90\) | 최소 / 중앙값 / 최대 | 꼬리 영역 오류 |
|---|---|---|---|---|---|---|---|
| 1 | has_number | 87.5% | [80.2, 93.8] | 13.5% | 74.0% | 0.04 / 0.99 / 1.00 | 3/84 = 3.6% [0, 8.1] |
| 2 | has_latin_word | 59.4% | [50.0, 69.8] | 2.1% | 57.3% | 0.09 / 0.93 / 0.98 | 0/57 = 0% |
| 3 | is_method | 32.3% | [22.9, 41.7] | 30.2% | 2.1% | 0.03 / 0.17 / 0.94 | – |
| 4 | has_counter | 36.5% | [27.1, 46.9] | 11.5% | 25.0% | 0.04 / 0.61 / 0.97 | – |
| 5 | states_main_claim | 1.0% | [0.0, 3.1] | 1.0% | 0% | 0.06 / 0.56 / 0.88 | – |
| 6 | is_important | 0.0% | [0.0, 0.0] | 0% | 0% | 0.48 / 0.67 / 0.82 | – |
| 7 | should_shorten | 0.0% | [0.0, 0.0] | 0% | 0% | 0.17 / 0.27 / 0.42 | – |
H2a는 지지된다. 선언된 순서와 \(\tau\) 사이의 Spearman \(\rho\)는 −0.955다. H2b도 지지된다. is_important와 should_shorten의 95% 상한은 모두 0.0이며, 두 명제 모두 어떤 답도 꼬리 임계값에서 0.07 이내로 다가가지 않았다. H2c는 등록된 점추정치 기준으로 지지된다 (has_number 3.6%, has_latin_word 0%; 0.5 기준 정확도는 94.8%와 91.7%). 다만 has_number의 근거는 빠듯하다. 부트스트랩 상한(8.1%)이 5%를 넘는다. 세 오류는 숫자가 있는 문단 하나가 0.05를 받은 경우와, 숫자가 없는 문단 둘이 0.97을 받은 경우였다. 공개 에세이에서 나온 41개 문단(이탈 사항 참조)으로 한정하면 명제 1–7의 \(\tau\)는 87.8, 51.2, 31.7, 41.5, 0.0, 0.0, 0.0%, \(\rho\) = −0.927로 H2a와 H2b는 변하지 않는다.
5.4 E3 — 반복 측정 안정성
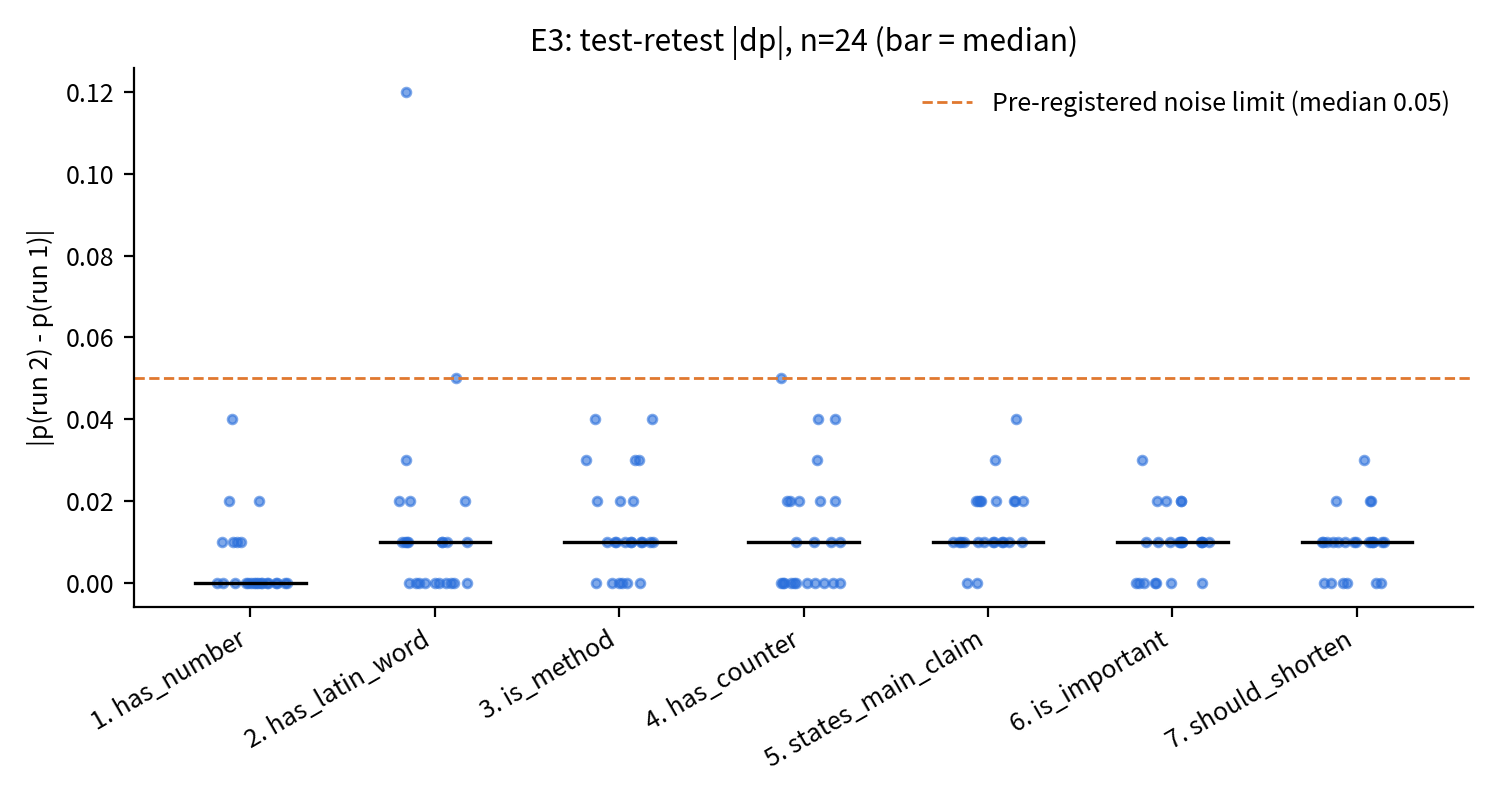
E2의 첫 24개 문단을 별도 실행에서 다시 제출해도 점수는 거의 변하지 않았다 (그림 3). \(|\Delta p|\)의 중앙값은 has_number에서 0.00, 나머지 여섯 명제에서 각각 0.01이었다. 90번째 백분위수는 0.02–0.04였고 단일 최대 변화는 0.12(has_latin_word)였다. 두 실행 사이에 꼬리 임계값을 넘나든 답은 없었다. 등록된 중앙값 기준 0.05를 넘는 명제가 없으므로, 어떤 명제에 대해서도 단일 호출은 고정 임계값 게이트에 쓰기에 잡음이 과다하다고 판정되지 않는다.
5.5 E4 — 모델 간 비교
gpt-5.6-luna는 288개 프롬프트 모두에 파싱 가능한 형태로 답했다. 그 \(\tau\)는 has_number에서 100% [100, 100], has_counter에서 87.5% [80.2, 93.8], is_important에서 85.4% [78.1, 92.7]로, Jev의 87.5%, 36.5%, 0.0%와 대비된다(그림 1). has_number에서 꼬리 영역 오류는 17/96 = 17.7%(Jev 3.6%), 0.5 기준 정확도는 82.3%였다. 등록된 세 조건이 모두 성립하므로 등록된 해석이 적용된다. Jev가 과소 확신한 것이 아니라 범용 LLM이 과잉 확신한 것으로 읽는다. luna의 오류 17개 중 열여섯 개는 ASCII 숫자가 없는 문단에 대해 \(p \ge 0.98\)로 숫자가 있다고 단정한 경우였다. 이 중 일부에는 한국어 수사가 들어 있다(예: 세 가지, “three kinds”). 탐색적으로 더 넓은 정답 정의(“ASCII 숫자 또는 한국어 수사”)를 쓰면 꼬리 영역 오류는 luna 11.5%(11/96), Jev 7.1%(6/84)가 된다. 등록된 해석은 여전히 유지되지만(11.5% > 5%), 두 모델 간 격차는 약 다섯 배에서 약 1.6배로 줄어든다. 숫자는 없고 수사만 있는 8개 문단에서 Jev의 점수는 0.04에서 0.97까지 퍼져 있었으므로, Jev 역시 이 문단들에서 일관되게 확신하지는 않았다.
5.6 E5 — 메일 재분석
메일 120건(정크 60건)에서 \(\tau\) = 5.0%(95% CI [1.7, 9.2])였고, 점수 범위는 0.08에서 0.98(중앙값 0.36)이었다. 그림 4 는 게이트 곡선이다. 자동 결정된 메일의 오류는 \(t = 0.15\)까지 0% (커버리지 9.2% [4.2, 15.0], 메일 11건), \(t = 0.20\)에서 4.2% [0, 13.3] (커버리지 20.0%), \(t = 0.25\)에서 22.5% [10.3, 35.9] (커버리지 33.3%), \(t = 0.30\)–\(0.40\)에서 36.9–38.8%(커버리지 54–86%)였다.
등간격 구간 열 개의 정크 비율은 0.00, 0.13, 0.67, 0.50, 0.07, 0.33, 0.57, 0.64, 1.00, 1.00이었다 (구간 크기 4, 8, 24, 28, 14, 9, 7, 14, 10, 2; 그림 5). 인접 감소는 2회로, 점수를 셔플했을 때의 평균 4.17보다 적었다. 단측 순열 \(p\)(셔플 5,000회)는 0.045로 \(\alpha = 0.05\)에서 유의하다. 즉 점수 순서는 셔플된 점수보다 단조성 위반이 적다. 그러나 이는 경계선 결과이며, 곡선이 단조롭다는 뜻은 아니다. 0.2–0.5 영역 (메일 66건, 55%)은 역전되어 있고(0.67 → 0.50 → 0.07), 등위 적합은 0.2에서 0.6까지의 구간을 0.45로 합친다. 위반 횟수가 아니라 이탈의 크기를 재는 탐색적 통계량(이탈 사항 참조)은 반대 방향을 가리킨다 (\(p\) = 0.94). 기준 레이블도 추가적인 유의점이다. 0.4–0.6 구간에서 폴더상 정상으로 분류된 메일 19건 중 12건은 모델 스스로 뉴스레터나 마케팅으로 분류한 것, 즉 메일 제공자가 받은편지함으로 전달한 대량 메일이었다. 따라서 겉보기 역전의 일부는 점수의 성질이 아니라 기준(폴더 배치)의 잡음일 수 있다.
5.7 사전등록으로부터의 이탈
- E5 분석 세부 사항은 프로토콜에 명시되지 않아 실행자가 E5 실행 전에 고정했다. 대칭 게이트 \(p \le t\) / \(p \ge 1-t\)와 \(t = 0.05, 0.10, \dots, 0.40\), 등간격 구간 열 개, 인접 구간 비율의 감소로 정의한 위반, 그리고 메일 간 점수를 셔플한 단측 \(p = \Pr(V_\text{perm} \le V_\text{obs})\)이다.
- 등록되지 않은 E5 통계량. 이에 더해 실행자는 구간 비율과 등위 적합 사이의 가중 제곱 거리(3.32)를 계산했고, 순열 \(p = \Pr(\text{perm} \le \text{obs}) = 0.94\)를 얻었다. 즉 단조성으로부터의 이탈이 대부분의 셔플보다 크다. 이 통계량은 탐색적이다. 두 통계량은 서로 어긋난다. 등록된 위반 횟수는 순서가 우연보다 낫다고 말하지만, 이탈의 크기는 그렇지 않다. 따라서 단조성에 관한 어떤 결론도 어떤 통계량을 택하느냐에 달려 있다.
- E4 전송 경로. gpt-5.6-luna는 OpenRouter가 아니라 OpenAI API로 직접 호출했으며, 추론 강도는 “low”(도구 기본값), 출력 한도는 1,000 토큰, 시스템 메시지는 JSON만 요청하는 한 줄이었다. 비용은 도구의 토큰 가격 추정치다.
- E1b 첫 실행 무효. 스크립트 버그로 문단 텍스트 대신 (파일, 텍스트) 튜플이 전송되어 측정 길이가 2가 되었다. 해당 실행은 폐기했고 동일한 등록 프로토콜로 E1b를 다시 실행했다. 폐기된 출력은 무효 표시를 해 따로 보관한다.
- E1b 등록 시점. E1b는 PREREG(18:39) 이후인 18:45에 등록되었다. 그 시점에 E1 출력 파일은 이미 디스크에 있었지만 등록자는 열어 보지 않았다.
- 말뭉치. 프로토콜은 말뭉치를 공개된 Insight Lab 저널로 기술했다. 그러나 실행 장비의 파일 글롭은 같은 저자의 미발표 초고 에세이 다섯 편과도 일치했다. 말뭉치 문단 297개 중 170개, E2 문단 96개 중 55개가 이 초고에서 나왔고, 이들은 Jev와 OpenAI API로 전송되었다. 여기에는 타인이나 고용주의 데이터가 없다. 공개분만 추린 부분집합(\(n = 41\))에서는 \(\rho\) = −0.927, \(\tau_6 = \tau_7 = 0\)(E2 소절)이므로 H2a와 H2b는 변하지 않는다.
- 경미한 사항. E3의 “별도 실행”은 E2 몇 분 뒤 동일 입력으로 시작한 별도 프로세스였다. E1 꼬리와 E2/E4 꼬리 영역 오류의 부트스트랩 CI, 0.5 기준 정확도, 공개분 부분집합, 넓은 정답 기준의 E4 재채점은 추가 분석이며 등록된 검정이 아니다. Jev 실행기는 예외 발생 시 문단당 한 번의 재시도를 허용했으나, 예외는 발생하지 않았다.
데이터를 본 뒤 명제 문구, 임계값, 표본을 바꾼 일은 없다.
6 논의
(a) 꼬리 두께는 사실성을 따라간다. 일곱 명제에 걸쳐 \(\tau\)는 선언된 선호성에 따라 거의 단조적으로 감소했다(\(\rho\) = −0.955). has_number는 88%, has_latin_word는 59%, 두 의미 명제는 32–37%, 독자의 판단이 필요한 세 명제는 0–1%였다. 순서는 데이터 수집 전에 고정되었고, 공개분 부분집합에서도 유지되었으며, 단일 호출이 충분히 안정적이었으므로(E3) 이 패턴은 모델의 표집 잡음이 아니다. 중간 대역(명제 3과 4)은 CI상 양 끝과 모두 구분된다.
(b) 역설. 꼬리가 두꺼운 명제는 규칙으로 이미 풀리는 명제다. has_number는 정규 표현식이며, 무료로 정답을 계산할 수 있었던 유일한 명제이기도 하다. 규칙으로 풀리지 않는 명제(is_important, should_shorten, states_main_claim)에는 사실상 꼬리가 없었다. 이 설정에서 저가 판단 모델은 가장 필요 없는 곳에서만 확신하며, 0.10/0.90 게이트는 규칙을 쓸 수 없는 항목에 대해서는 거의 아무것도 처리하지 못한다.
(c) 범용 LLM은 반대 방향으로 실패한다. gpt-5.6-luna는 거의 항상 단정했다. has_number 답의 100%와 is_important 답의 85%가 꼬리에 있었고, 사실 명제에서 확신에 찬 오류가 17개 있었다. luna에 꼬리 기반 게이트를 달면 커버리지는 높겠지만 그 오류들을 그대로 통과시킨다. 이에 비추면 선호 명제에서 Jev의 얇은 꼬리는 과소 확신이 아니라 캘리브레이션된 신중함으로 읽히며, 이것이 등록된 E4 해석이다. 두 가지 단서가 붙는다. 더 넓은 정답 정의를 쓰면 사실 오류 격차가 약 1.6배로 줄고, 두 모델은 서로 다른 프롬프트 형식을 받았다. 실무적 교훈은 \(\tau\)만으로는 유용한 확신과 과잉 확신을 구분할 수 없다는 것이다. 꼬리 기반 게이트는 반드시 꼬리 영역 안의 오류 점검과 함께 써야 한다.
(d) 루브릭 결과가 말할 수 있는 것과 없는 것. 파일럿 루브릭은 is_important의 점수 분산을 넓혔지만 꼬리를 만들지는 못했다. E1은 그 원인이 선호형 프레이밍이 확신을 억누르기 때문인지, 아니면 줄이기 루브릭에 모델이 평가하지 못하는 길이 조건이 들어 있었기 때문인지를 가리려고 등록했다. E1과 균형 설계의 E1b 모두 교란으로 판정되었다. Jev는 글자 수를 세지 못하고 기본적으로 “길지 않다”고 답한다. 따라서 프레이밍과 글자 수 세기를 분리할 수 없었고, 그 점에서 루브릭 탐색의 영결과는 여전히 해석할 수 없다.
(e) 실무 절차. 실제 입력 흐름의 약 24–96개 항목에서 레이블 없이 \(\tau\)를 측정한다. \(n = 96\)에서 E2의 CI는 최대 약 ±10 포인트였고, E3는 항목당 한 번의 호출로 충분함을 시사한다. \(\tau\)가 작으면 거기서 멈춘다. 게이트가 줄일 수 있는 상위 처리 비용의 상한은 \(\tau\)다(3절). \(\tau\)가 크면 꼬리 항목에서만 뽑은 소수의 레이블로 꼬리 영역 오류를 표본 점검하고, 임계값 근처에서 점수 순서가 단조적인지 확인한다. 이는 앞선 파일럿의 주장을 바로잡는다. SP26 (Insight Lab 2026년a)은 꼬리가 5–10%인 게이트를 “순수 손실”이라고 기술했는데, 이는 과장이었다. 저가 호출은 그것이 걸러 내는 상위 처리보다 약 두 자릿수 저렴하므로 추가 API 비용은 무시할 만하다. 올바른 진술은 절감액의 상한이 \(\tau\)라는 것, 즉 작지만 음수는 아니라는 것이며, 만들 가치가 있는지는 호출당 가격이 아니라 통합과 모니터링의 고정비가 결정한다는 것이다.
7 한계
- 저가 모델 하나. 모든 Jev 결과는 한 판단 모델의 한 버전을 제로샷으로 쓴 것이며, 비교 대상도 범용 LLM 하나다.
- 한 언어, 한 말뭉치. 한국어 과학 에세이와 메일 표본 하나를 썼고, 에세이와 선행 파일럿, 본 논문을 모두 한 저자가 썼다.
- 말뭉치 내 미발표 초고. E2 문단의 절반 이상이 저자의 미발표 초고에서 나왔다. 공개분 부분집합도 같은 정성적 결과를 주지만 규모가 작다(\(n = 41\)).
- 작은 \(n\). 항목 수는 24–120개이고, E5 구간에는 메일이 2–28건 들어 있으며, has_number의 H2c 상한 (8.1%)은 5% 기준을 넘는다.
- has_number의 정답 정의. 등록된 정답은 ASCII 숫자다. 한국어 수사를 포함하면 두 모델의 오류율이 모두 바뀌며(E4 소절), Jev–luna 격차도 이 선택에 좌우된다.
- 서로 다른 프롬프트 형식. luna는 JSON 확률을 요청하는 자유 텍스트 프롬프트를 받은 반면, Jev는 구조화된 API로 이름 붙인 명제를 받았다. 꼬리 차이의 일부는 형식 때문일 수 있다.
- 경계선의 E5. 등록된 단조성 검정은 \(p\) = 0.045, 탐색적 통계량은 \(p\) = 0.94를 준다. 메일 점수의 단조성이 확립되었다고 보지 않는다.
- 불균형한 E1. 등록된 E1 표본에는 양성 항목이 하나였다. 추가 등록한 E1b가 이를 보완하지만 역시 규모가 작다(\(n = 24\)).
- 고정 임계값. 0.10/0.90만 등록했으며, 메일 레이블은 메일 서비스의 폴더에서 가져왔다.
8 결론
꼬리 두께는 레이블 없이 측정할 수 있으며, 두 임계값 게이트가 절감할 수 있는 몫에 상한을 준다. 사전등록된 다섯 개 실험과 등록된 추가 실험 하나에서, 꼬리 두께는 명제의 선호성이 커질수록 감소했고(\(\rho\) = −0.955), 선호 명제에서는 0%였으며, 반복 호출에도 안정적이었다. 범용 LLM은 반대 패턴을 보여, 틀린 경우를 포함해 극단적 확률로 단정했다. 선호형 프레이밍과 모델의 글자 수 세기 불능은 분리하지 못했고, 메일 데이터의 단조성 결과는 어떤 통계량을 택하느냐에 달려 있다. 본 논문이 권하는 선별 절차는 소박하다. 먼저 \(\tau\)를 측정하고, 게이트를 만들기 전에 꼬리 안의 오류를 점검하라.
데이터 및 코드 가용성
실험 스크립트, SHA-256 다이제스트가 포함된 사전등록 파일, 익명화된 JSON 출력(문단 번호, 길이, 정답 플래그, 반환 확률; 메일 레이블과 확률)은 저자의 아카이브에 보관되어 있으며 요청 시 저자에게서 받을 수 있다. 공개 데이터에는 문단 본문이나 e-메일 내용이 저장되지 않는다.